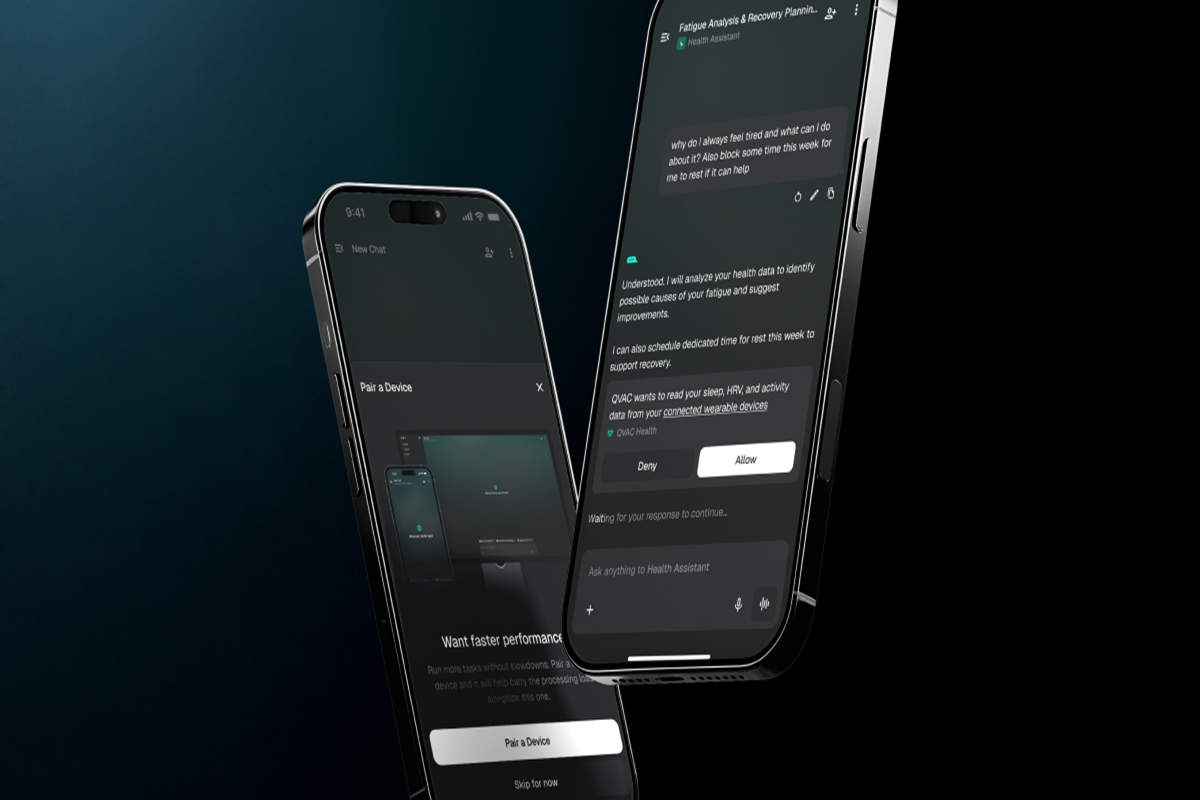
Когда в 2020 году вышла GPT-3 от OpenAI с 175 млрд параметров, это была крупнейшая языковая модель в истории. В последующие годы передовые системы ИИ стремительно росли, и у крупнейших современных моделей уже значительно больше триллиона параметров. Но параллельно развивается и противоположное направление: исследователи, в том числе Tether, создают новое поколение компактных моделей.
Таким моделям нужна лишь малая часть вычислительных мощностей, требуемых их более крупным аналогам. Это способствует переходу к ИИ, работающему непосредственно на устройстве: всё больше приложений запускаются локально, без обращения к облаку.
Даже крупнейшие компактные модели Tether насчитывают около 4 млрд параметров — совсем немного по сравнению с передовыми системами. Другие модели достаточно малы, чтобы работать на обычном смартфоне. После загрузки им не требуется подключение к интернету.
Крупные модели и пределы масштабирования
Стремясь увеличить контекстное окно, улучшить рассуждения и добавить мультимодальные возможности, лаборатории ИИ за последние годы значительно увеличили модели. Число параметров, размер вычислительного кластера и потребление электроэнергии в мегаваттах нередко используют как косвенные показатели их возможностей.
Такой подход предполагает, что больше — всегда лучше. Долгое время это подтверждали закономерности масштабирования: предсказуемые математические зависимости, согласно которым увеличение числа параметров, объёма обучающих данных и вычислительных мощностей напрямую улучшало результаты и позволяло моделям демонстрировать новые способности. Чтобы создавать более интеллектуальные системы, разработчикам передовых моделей оставалось вкладывать в задачу всё больше ресурсов.
Однако от простого наращивания масштабов ИИ отдача постепенно снижается. Мощности дата-центров по всему миру быстро растут, но запас созданных людьми обучающих данных, благодаря которым языковые модели развивались до сих пор, становится всё менее доступным.
Кроме того, снижение перекрёстной энтропии — именно её фактически измеряют закономерности масштабирования — не было прямым показателем роста возможностей ИИ. На деле самые значительные улучшения обычно обеспечивали более качественные обучающие данные, новые методы и оригинальные архитектуры. На фоне стремительного роста инвестиций в ИИ, строительства дата-центров гигаваттной мощности и многомиллиардных бюджетов на облачные вычисления исследователи всё чаще сомневаются, что дальнейшее увеличение масштабов останется столь же важным условием прогресса.
Развитие компактного ИИ
Пока несколько крупных лабораторий борются за лидерство в создании передовых систем, интересные разработки появляются и за пределами этой гонки.
Компактные модели Tether охватывают разные задачи: медицинские рассуждения (MedPsy), перевод (TranslatePsy) и обработку изображений (VisionPsy).
По утверждению компании, в каждой из этих областей специализированные компактные модели регулярно превосходят более крупные универсальные модели при выполнении конкретных задач и при этом без проблем работают на стандартном потребительском оборудовании.
Чтобы уместить больше возможностей в меньшую модель, исследовательская команда QVAC компании Tether сосредоточилась на отборе обучающих данных и методах сжатия, включая квантование.
Недавно команда выпустила Genesis III: в корпус синтетических обучающих данных предыдущих поколений добавили 191 млрд токенов по 19 направлениям STEM — естественным наукам, технологиям, инженерии и математике. В отличие от огромных массивов данных, собранных из интернета и использовавшихся для обучения первых больших языковых моделей, наборы Genesis узкоспециализированы. Их можно сравнить с учебниками: они содержат правильные и неправильные примеры, а также последовательности шагов рассуждения, помогающие моделям развивать знания в определённой области.
Помимо подготовки качественных обучающих данных, Tether применяет квантование, чтобы модели работали эффективнее. В отличие от дистилляции, при которой уменьшают число параметров модели, квантование заменяет высокоточные веса на более компактные веса с меньшей разрядностью, занимающие меньше памяти.
В проектах с открытым исходным кодом стандартом стали модели с 8- и 4-битными весами. На переднем крае разработки ИИ для устройств впечатляющие результаты уже показывают даже модели с одноразрядными весами.
SDK QVAC повышает эффективность
Чтобы перенести ИИ на потребительские устройства, недостаточно просто уменьшить модели. QVAC также предлагает модульный инструментарий для разработки полноценных приложений; его компоненты оптимизированы для оборудования, которым оснащены смартфоны и персональные компьютеры.
Например, в SDK QVAC интегрирован TurboQuant — инструмент с открытым исходным кодом для сжатия памяти. Он позволяет уменьшить размер KV-кэша (кэша ключей и значений) моделей ИИ до 80%.
Последнее дополнение к комплекту средств разработки — TurboVec — предназначено для поиска и извлечения данных. Это ещё одна область, где возможности приложений на устройстве ограничены объёмом памяти и вычислительными мощностями.
Если нагрузка ИИ превышает возможности одного устройства, кластерный инференс, добавленный в то же обновление SDK, позволяет разработчикам объединять ресурсы нескольких машин. Благодаря этим решениям мощные функции, прежде доступные только в облачных системах ИИ, теперь могут работать на рабочем столе или в кармане.
На фоне снижения отдачи от простого увеличения масштабов моделей и растущего недовольства существующим положением дел компактные модели Tether предлагают исследовать новые возможности ИИ.